一、「有多少件」这个问题没有唯一答案。案由口径 148,500 条、标题口径 238,139 条、并集 255,758 条, 三个数都对,取决于你问的是哪一路。原因见第一节——两个入库批次的案由字段 100% 为空。
二、记录数 ≠ 案件数。一个案件常有一审判决、二审裁定、执行裁定多份文书。 本页所有表格同时给出记录数与相异案号数,论文里请引后者。
三、这个案由里有两个超大批量诉讼簇。它们占全部相异案号的 3.45%, 却贡献了 97.4% 的第三人撤销之诉。做法院画像或结果预测前必须先剔除,见第五节。
一、主题定义与三种口径
「股权转让纠纷」在裁判文书里有两个互不重合的识别入口,本页把两条路都跑出来并取并集。
| 口径 | 记录数 | 相异案号数 | 说明 |
|---|---|---|---|
案由口径(cause 字段精确等值「股权转让纠纷」) | 148,500 | 124,034 | 字面纯度 100%(keyword 精确等值,不是分词 OR) |
标题口径(title 短语含「股权转让」) | 238,139 | 202,441 | 抽样纯度 40/40,见第七节 |
| 两路交集 | 130,881 | — | |
| 并集(本页主口径) | 255,758 | 211,793 | 后文除特别说明外均指此口径 |
正文口径(body 短语含「股权转让」) | 619,405 | — | 含大量只是提到股权转让的其他案由,不建议作为案件集 |
为什么案由口径会漏掉 42% 的案件?不是数据脏,是字段缺失有批次性。
按入库批次拆开看,ws_new(59,473 条)与 2021(36,858 条)两个批次的 cause 字段
逐条为空,合计 96,331 条——占「只有标题路能捞到」那 107,258 条的 89.8%。
换句话说,只用案由字段做筛选,等于把这两个批次对应的年代整段丢掉,而这恰好是 2019 年之前与 2020–2021 的主力批次。
二、逐年记录量:绝对值会骗人,归一化才不会
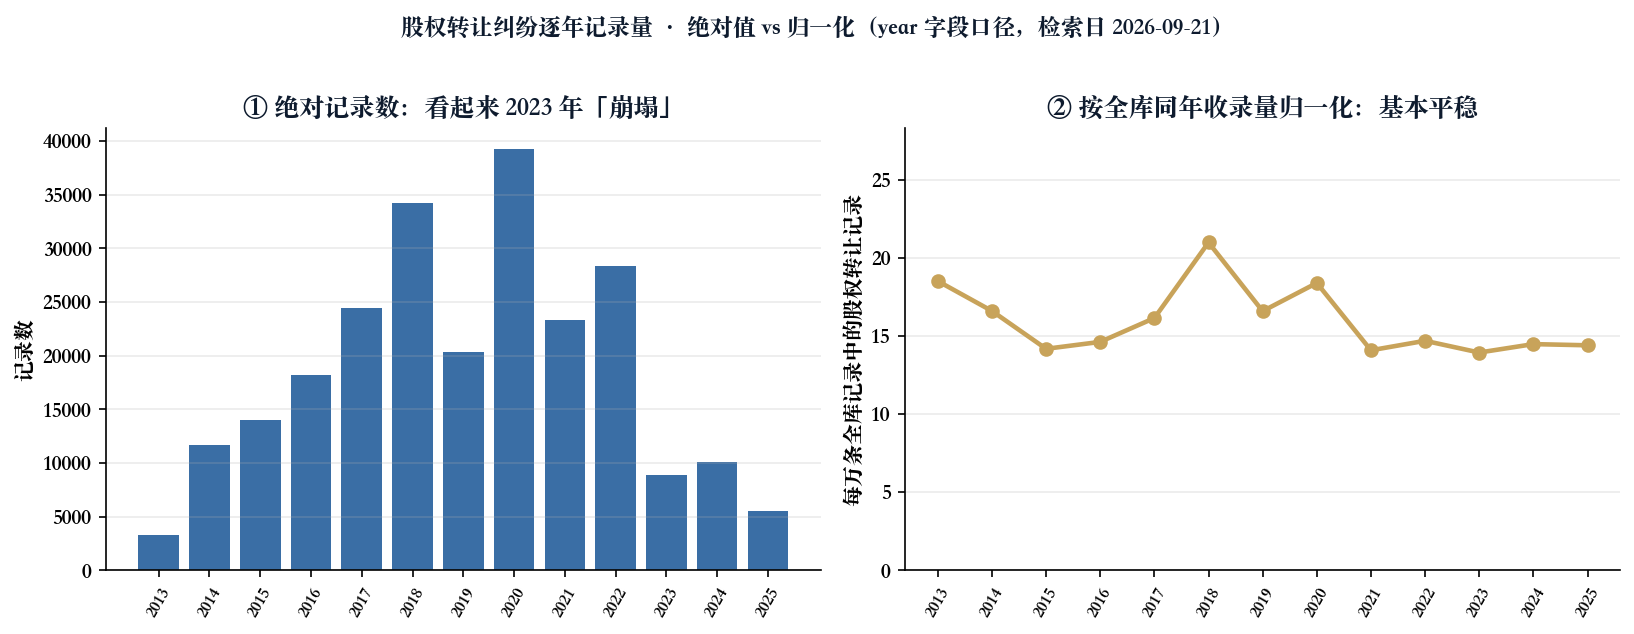
年份(year 字段) | 记录数 | 相异案号数 | 全库同年记录数 | 每万条中的占比 |
|---|---|---|---|---|
| 2013 | 3,263 | 2,829 | 1,762,537 | 18.51 |
| 2014 | 11,676 | 10,342 | 7,033,956 | 16.60 |
| 2015 | 14,027 | 12,477 | 9,894,747 | 14.18 |
| 2016 | 18,192 | 16,314 | 12,443,177 | 14.62 |
| 2017 | 24,456 | 22,988 | 15,147,489 | 16.15 |
| 2018 | 34,273 | 27,635 | 16,331,967 | 20.99 |
| 2019 | 20,388 | 16,313 | 12,290,542 | 16.59 |
| 2020 | 39,282 | 29,461 | 21,359,050 | 18.39 |
| 2021 | 23,303 | 20,742 | 16,548,198 | 14.08 |
| 2022 | 28,341 | 19,566 | 19,292,669 | 14.69 |
| 2023 | 8,872 | 8,245 | 6,365,236 | 13.94 |
| 2024 | 10,112 | 9,967 | 6,984,435 | 14.48 |
| 2025 | 5,499 | 5,487 | 3,818,342 | 14.40 |
结论:2022→2023 绝对记录数跌 68.7%,归一化后只跌 5.1%。 十三年里归一化占比的极差是 13.94–20.99(1.51 倍),而绝对值的极差是 3,263–39,282(12.0 倍)。 所以「2023 年股权转让诉讼断崖式下跌」这个结论,在本库里主要是文书公开量收缩的收录效应, 而不是纠纷本身减少。任何一篇按年画折线的实证论文,如果没做这一步归一化,第一轮外审就该被问住。
⚠️ year 字段派生自 date,而 date 在 2024、2021_x、2022_x 三个批次(占全库 12.37%)
存的是发布/采集日而非落款日。所以上表既不是严格的「起诉年」,也不是严格的「裁判年」,
按落款日重分桶会让 2024 行明显变小、2021 行变大。引用时请连这句一起引。
三、地域分布
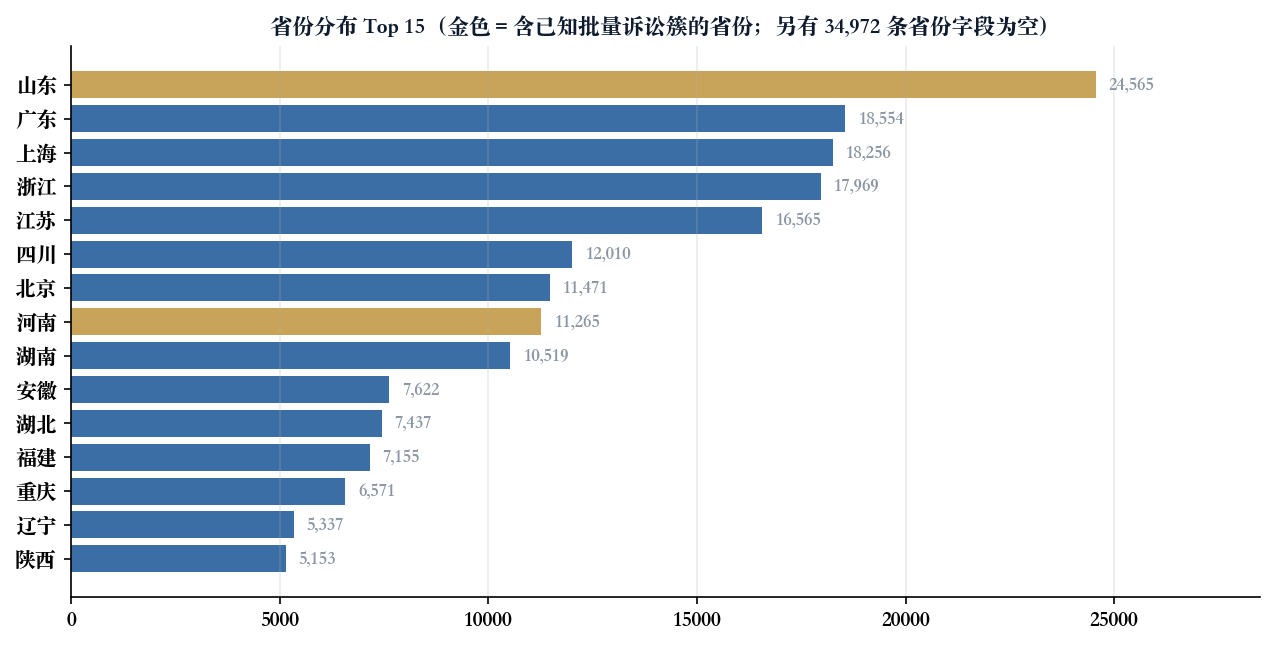
三点必须说明,否则这张图会被用错:
- 省份字段 13.67% 为空(34,972 条),空值不是随机分布的,按批次聚集。
- 同一个省有两种写法:
广东省14,642 +广东3,912,浙江省14,103 +浙江3,866…… 只认带「省」字的写法会系统性少算 20% 左右。上图已做归并。 - 山东第一(24,565)与河南第八(11,265)都被批量诉讼簇推高: 仅济南市天桥区人民法院一家就贡献 10,705 条,汝州市人民法院贡献 3,492 条,见第五节。剔除后排序会变。
四、审级与文书类型
审级(已归并三套编码)
procedure 字段在库里同时存在中文全称(民事一审)、中文简称(一审)、
纯数字码(1/2)与四位码(0301/0302)四种写法。只认其中一种会漏掉一半以上。
| 审级 | 记录数 | 相异案号数 | 归并的写法 |
|---|---|---|---|
| 一审 | 139,127 | 120,213 | 民事一审 / 一审 / 1 / 0301 |
| 二审 | 45,178 | 40,066 | 民事二审 / 二审 / 2 / 0302 |
| 执行 | 26,383 | 22,625 | 执行实施 / 首次执行 / 执行审查 / 执行异议 / 执行复议等 |
| 再审审查与审判监督 | 8,610 | 7,969 | 民事审判监督 / 再审 / 再审审查与审判监督 / 0303 / 3 |
| 第三人撤销之诉 | 1,876 | — | 第三人撤销之诉(其中 1,828 件来自同一原告,见第五节) |
| 管辖类 | 1,817 | — | 民事管辖 / 民事管辖上诉 / 民事指定管辖 / 管辖 |
| 字段为空 | 29,843 | — | — |
文书类型(按标题后缀判定)
⚠️ 这里不能用 caseType 字段:该字段把「案件类型」(民事案件/执行案件)与
「文书种类」(判决/裁定)混在同一列,且民事有 民事案件 88,455 与 民事 55,239 两种写法。
另有一个已知陷阱:部分批次的正文首行一律写「判决书」,按正文判种类会把裁定书误判成判决书,因此只信标题。
| 文书类型 | 记录数 | 占并集 |
|---|---|---|
| 裁定书 | 124,298 | 48.6% |
| 判决书 | 95,358 | 37.3% |
| 调解书 | 10,438 | 4.1% |
| 决定书 | 445 | 0.2% |
| 标题无可识别后缀 | 25,219 | 9.9% |
裁定书比判决书多,是这个案由的结构性特征,不是数据缺陷——管辖异议、保全、撤诉、执行实施都出裁定。 这也是本页第六节拒绝报「支持率」的直接原因之一。
五、批量诉讼簇:3.45% 的案号,97.4% 的第三人撤销之诉
这是本页最该被写进论文数据说明的一节。本案由里存在两个互相关联的超大诉讼复合体:
| 诉讼簇 | 记录数 | 相异案号数 | 占全案由案号 | 主要法院 |
|---|---|---|---|---|
| 济南产业发展投资集团有限公司 | 10,779 | 4,855 | 2.29% | 济南市天桥区法院 9,025、济南中院 1,725 |
| 自然人 陈宏庆 | 6,572 | 4,333 | 2.05% | 天桥区法院 1,828、济南中院 1,725、汝州市法院 2,287、平顶山中院 717 |
| 两簇并集 | 13,798 | 7,307 | 3.45% | 横跨山东、河南两省四家法院 |
为什么它比 3.45% 这个数字更危险:
- 它不是均匀摊在库里的,而是堆在特定切片上。 济南市天桥区人民法院这一法院切片共 10,705 条股权转让记录,其中 8,883 条正文出现「济南产业发展投资集团」, 占该法院该案由的 83.0%。任何「哪家法院股权转让案最多」的排行,第一名就是这么来的。
- 它垄断了一整个程序类型。全案由 1,876 件第三人撤销之诉里, 1,828 件(97.4%)的原告是陈宏庆一人。用本库统计「第三人撤销之诉在公司类纠纷中的适用情况」, 实际上是在统计一个人的诉讼策略。
- 它跨省,所以按省份剔除剔不干净。同一自然人同时在山东济南与河南汝州两地提起批量诉讼。
抽样核验(random_score,seed=20260921):
- 天桥区法院切片,n=40:30 条「济南产业发展投资集团」列原告或申请执行人,
7 条为陈宏庆诉该集团的第三人撤销之诉,3 条正文为空(全部来自
2019_2批次)。 可读的 37 条全部属于同一诉讼复合体(37/37)。批次分布:2022 批 25、2021 批 5、ws_new 4、2019_1 3、2019_2 3。 - 汝州市法院切片,n=20:20 条原告均为陈宏庆(含法院匿名化后的「陈某」「陈某某」)。 样本量 20 < 30,不构成统计结论,仅作定性指示;该切片总量 3,492 条。
给研究者的处理建议:做法院层面的描述统计前,先按「同一法院 × 同一当事人 × 同一年份」聚类, 把超过 200 件的簇单列出来,并在论文里说明是否剔除。本页所有非簇统计均未剔除, 因为剔除标准本身需要随研究问题而定——这也是我们把簇的规模单独量化出来的原因。
六、诉请关键词交叉,以及为什么本页不报支持率
六组诉请关键词共现
以下为并集内正文短语共现计数,组间互相重叠(一份判决可同时命中多组),不可相加。
| 关键词(正文短语) | 记录数 | 相异案号数 | 占并集案号 |
|---|---|---|---|
| 股权转让款 | 83,104 | 73,067 | 34.5% |
| 工商变更登记 | 25,272 | 22,483 | 10.6% |
| 优先购买权 | 9,652 | 8,631 | 4.1% |
| 解除股权转让 | 7,933 | 7,027 | 3.3% |
| 股权代持 | 3,788 | 3,360 | 1.6% |
| 确认股东资格 | 1,824 | 1,651 | 0.8% |
| 对赌 | 1,091 | 952 | 0.4% |
| 国有产权 | 317 | 281 | 0.13% |
| 瑕疵出资 | 248 | 212 | 0.10% |
「优先购买权」用默认 match_phrase 检索,结果是 0 条;
「确认股东资格」是 3 条。两个数都是假的。
原因:索引侧按 ik_max_word 切词,「优先购买权」被切成
优先购买 / 优先 / 购买 / 权;查询侧默认走 ik_smart,切成
优先购买 / 权。两串 token 的位置序列对不上,短语匹配直接落空。
把查询分词器显式指定为 ik_max_word 之后,同一条件命中 9,652 条
和 1,824 条。上表用的是后者。
这意味着:在任何全文库里检索到某个法律术语「零结果」,都不能直接写成「该术语从未出现」—— 先换分词器复核,或改用词项 AND 检索取并集。这条坑同样适用于法条号(带「第」字的短语)与机构全名。
为什么本页不报诉请支持比例(也不报胜诉率)
这是刻意的取舍,不是做不出来。在本页的口径下,任何一个「支持率」都会至少踩中下面三条中的一条:
- 分母不干净。并集里 124,298 条是裁定书(48.6%),管辖、保全、撤诉、执行实施类裁定 根本没有实体裁判结果。放进分母会把比例系统性压低;要剔出去,又得先解决文书种类的批次级误标问题。 同一个「支持率」,按判决书做分母和按全部文书做分母,差出的不是几个百分点,是一倍以上。
- 分子取不全。本报告数据采集时库内正文保留前 6,000 字(该截断已于 2026-09 补齐,本报告口径未回溯重算),长判决的判决主文可能整段落在截断之外, 用正则从正文抽「本院判决如下」会在长文书上系统性失败——而长文书恰恰是争议大、标的高的那批。
- 簇污染。第五节那 7,307 个案号里有数千件是同一模板判决, 它们会把结果分布整体拉向一个方向,而这个方向只代表一个债权人的诉讼策略。
所以本页只做「有多少、在哪里、什么程序、诉请里提到什么」这四类可核验的计数, 把结果维度留给需要人工校验的定制统计。 需要更细的交叉与逐案清单——比如按省份 × 审级 × 诉请类型的交叉表, 或剔除批量诉讼簇之后的法院画像,或带人工复核的裁判结果归类—— 可以按研究主题定制数据报告, 交付 Word + Excel + PPT + 图表,每个数字同样附检索式。
七、方法与局限
方法
- 数据底座:自建裁判文书全库,
judgments索引共 160,291,678 条记录(检索日 2026-09-21), 来源为中国裁判文书网公开生效裁判文书,多数文书的当事人姓名已由法院匿名处理。 - 统计方式:全部为全库实时聚合,非抽样外推。记录数取
track_total_hits真值; 相异案号数取cardinality(precision_threshold=40000)。 - 纯度核验:案由口径为
term精确等值,字面纯度 100%; 标题口径按random_score(seed=20260921)抽 n=40 人工读标题, 40/40 标题含「股权转让纠纷」或「股权转让协议纠纷」,批次分布 ws_new 24 / 2021 14 / ws 2 ——与「案由字段空批次」的分布一致,说明标题路补回来的是元数据缺失的同族案件,不是话题漂移。
已知局限(六条,建议原样写进论文的数据说明)
year字段的语义不统一。它派生自date,而date在2024、2021_x、2022_x三个批次(占全库 12.37%)是发布/采集日而非落款日。 第二节的逐年表因此既非严格起诉年也非严格裁判年。2019_2批次正文全空,本并集内涉及 8,480 条。任何基于正文的计数(第六节全部) 在这批上必然为零,属于系统性漏计而非真实缺席。- 正文 6,000 字截断(采集时)。本报告采集时超长文书只保留前 6,000 字(已于 2026-09 补齐,本页数字未回溯重算),影响正文短语命中与结果抽取。
- 省份字段 13.67% 为空(34,972 条),且空值按批次聚集,不可视为随机缺失。
- 相异案号数为近似值。
cardinality是 HyperLogLog 近似算法, 在十万量级上典型误差在 1% 以内,但不是精确去重;且案号写法存在全角/半角括号差异,未做归一化前可能略有高估。 - 记录数 ≠ 案件数 ≠ 纠纷数。一个案件常对应多份文书;一起纠纷也可能拆成多个案号。 本页所有表格同时给出两个数,请按研究问题选择。
八、附录:检索式(可原样复现)
以下为本页全部数字的检索式(Elasticsearch Query DSL 片段,检索日 2026-09-21)。
三种口径
案由口径:  {"term": {"cause": "股权转让纠纷"}}
标题口径:  {"match_phrase": {"title": "股权转让"}}
并集口径:  {"bool": {"should": [<案由口径>, <标题口径>], "minimum_should_match": 1}}
相异案号:  "aggs": {"d": {"cardinality": {"field": "caseNo", "precision_threshold": 40000}}}
逐年与归一化
分子: <并集口径> + "aggs": {"y": {"terms": {"field": "year", "size": 20, "order": {"_key": "asc"}}}}
分母: {"range": {"year": {"gte": 2013, "lte": 2025}}} + 同一 terms 聚合
归一化 = 分子(该年) / 分母(该年) × 10000
正文短语(必须显式指定分词器)
{"match_phrase": {"body": {"query": "优先购买权", "analyzer": "ik_max_word"}}}
# 省略 analyzer 走默认 ik_smart,同一条件返回 0 条(假零)
批量诉讼簇
产发簇: <并集> ∧ {"match_phrase": {"title": {"query": "济南产业发展投资集团", "analyzer": "ik_max_word"}}}
陈宏庆簇: <并集> ∧ {"match_phrase": {"title": {"query": "陈宏庆", "analyzer": "ik_max_word"}}}
法院切片: {"terms": {"court": ["山东省济南市天桥区人民法院", "济南市天桥区人民法院"]}}
          {"terms": {"court": ["河南省汝州市人民法院", "汝州市人民法院"]}}
抽样
{"query": {"function_score": {
   "query": <目标切片>,
   "functions": [{"random_score": {"seed": 20260921, "field": "_seq_no"}}],
   "boost_mode": "replace"}}, "size": 40}
需要这个主题更细的切片,或换一个研究主题?
按研究主题在 1.6 亿全库上定制统计:逐年量、案由构成、地域审级画像、关键词交叉、裁判结果归类, 交付 Word + Excel + PPT + 图表,每个数字附检索式。基础版 ¥299 起,24–72 小时交付。
数据报告定制 → 📩 chenjiaxin@wenshucha.com九、常见问题
库里一共有多少股权转让纠纷的文书?
取决于口径,三个数都对:按案由字段精确等值「股权转让纠纷」是 148,500 条记录;按标题短语含「股权转让」是 238,139 条;两者并集 255,758 条记录、211,793 个相异案号。差距不是数据质量问题,而是 ws_new 与 2021 两个入库批次的案由字段 100% 为空(合计 96,331 条),只能靠标题路召回。写论文时必须写明用的是哪一路,并报相异案号数而不只是记录数。检索日 2026-09-21。
股权转让纠纷是不是从 2023 年开始大幅减少了?
按绝对记录数看像是:2022 年 28,341 条、2023 年 8,872 条,跌 68.7%。但同期全库该年收录量也从 1,929 万跌到 637 万。按「每万条全库记录中的股权转让记录」归一化后,2022 年是 14.69、2023 年是 13.94,只跌 5.1%。所以这主要是文书公开量收缩造成的收录效应,不是诉讼本身崩塌。任何按年画的曲线都必须先做这一步归一化。
这份数据里有没有批量诉讼导致的偏差?
有,而且不小。两个互相关联的诉讼复合体——济南产业发展投资集团有限公司(10,779 条记录 / 4,855 个相异案号)与自然人陈宏庆(6,572 条 / 4,333 个案号,横跨山东济南与河南汝州两省四院)——并集 13,798 条记录、7,307 个相异案号,占全案由相异案号的 3.45%。更极端的是:全案由 1,876 件第三人撤销之诉里,1,828 件(97.4%)来自陈宏庆一人。用这批数据做法院画像、当事人画像或结果预测,不剔除这两簇会被严重带偏。
为什么这份报告不报诉请支持率或胜诉率?
因为在本页的口径下报不准,报了就是误导。三个原因:一是并集里 124,298 条是裁定书(含大量管辖、执行、保全裁定),它们没有实体裁判结果,放进分母会稀释、剔出去又要先解决裁定/判决的批次级误标问题;二是本报告数据采集时库内正文保留前 6,000 字(该截断已于 2026-09 补齐,本报告口径未回溯重算),长判决的主文可能落在截断之外;三是上述批量诉讼簇会把结果分布整体拉向同一模板判决。需要结果维度的统计,我们按课题单独做口径设计与人工校验,见数据报告定制。
「优先购买权」在库里检索为什么会出现 0 条?
这是分词假零,不是真的没有。索引侧按 ik_max_word 切成「优先购买/优先/购买/权」,而查询侧默认用 ik_smart 切成「优先购买/权」,短语位置对不上,match_phrase 返回 0。把查询分词器显式指定为 ik_max_word 后,同一条件命中 9,652 条记录。「确认股东资格」同理:默认 3 条,指定分词器后 1,824 条。凡是看到某个法律术语「检索为零」,先换分词器复核再下结论。
这些数字能直接写进论文吗?
可以引用,但必须连口径一起引。本页每个数字都附了检索式与检索日期(2026-09-21),并在第七节列出了六条已知缺陷:year 字段在三个批次是发布日不是落款日、2019_2 批次正文全空、正文 6,000 字截断(采集时如此,已于 2026-09 补齐)、省份字段 13.67% 为空、相异案号用 HLL 近似算法、以及一案多文书导致记录数不等于案件数。审稿人问到的通常就是这几条,建议直接把它们写进论文的数据说明。